先说结论
T0 是一次词级 embedding 可行性实验。它没有训练句子 FOLD/READ,也没有生成文本;它只问一个 更靠前的问题:能否把高维词汇条件概率场压缩进一棵多尺度树,并随着读取分辨率增加,逐步 取回更多可验证的信息?
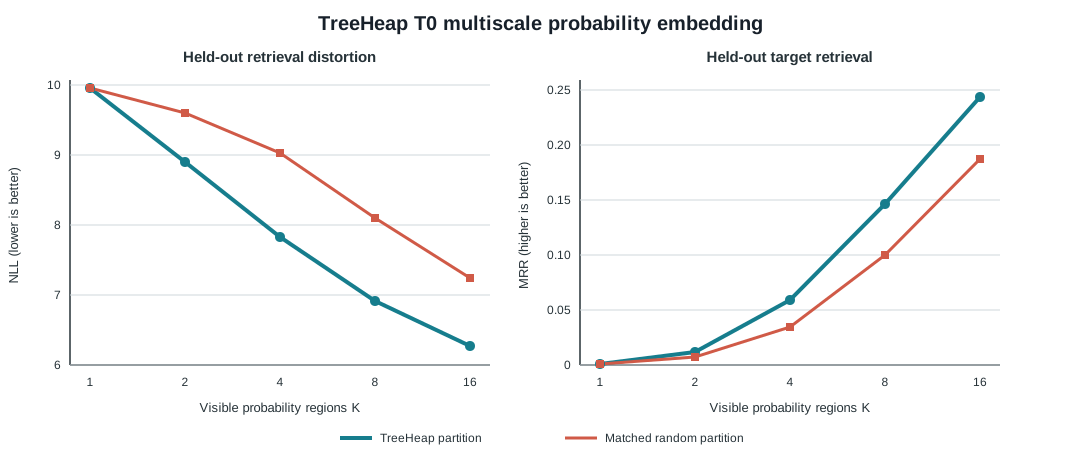
正式实验给出了第一条清楚的曲线:
| 可见概率区域数 (K) | TreeHeap NLL | 随机分区 NLL | TreeHeap MRR |
|---|---|---|---|
| 1 | 9.952945 | 9.952945 | 0.001171 |
| 2 | 8.898135 | 9.594337 | 0.011370 |
| 4 | 7.826886 | 9.021866 | 0.059431 |
| 8 | 6.909275 | 8.098312 | 0.146351 |
| 16 | 6.274350 | 7.241480 | 0.243256 |
分辨率从 1 -> 2 -> 4 -> 8 -> 16 增加时,TreeHeap 的留出 NLL 连续下降,MRR 连续上升;在
每个非退化尺度上,它都优于具有相同可见区域数、相同平滑和相同叶容量的随机分区。
这里压缩的是什么
实验从 WMT 英文侧抽取 200,000 行,其中 180,000 行用于构造背景场,20,000 行只用于留出测量。 词表中有 8,192 个目标 token 和 4,096 个 context token。
先定义训练语料的共现矩阵:
$$ N_{t,c}=\operatorname{count}(\text{target }t,\text{ context }c) $$实验使用左右窗口 4。这里必须先区分两类对象:
- 沿树下坠的是 4,096 个 context token;
- 最终被表示的是 8,192 个目标 token。
context 先按照自己的条件分布进入树的不同路径;目标 token 再根据它与各个 context 的共现 计数,得到一组跨叶概率质量。这组概率质量才是本次实验生成的 embedding。
context 如何从 root 下坠
对每个 context (c),构造 8,192 维条件特征:
$$ x_c(t)=\sqrt{P(t\mid c)} =\sqrt{\frac{N_{t,c}+\alpha} {\sum_u N_{u,c}+|V_t|\alpha}} $$平方根把概率分布放进 Hellinger 几何,使 context 之间的欧氏距离能够反映条件分布差异。 context 在语料中的总质量为:
$$ w_c=\sum_t N_{t,c} $$在树的某个节点 (S) 内,先计算质量加权中心:
$$ \mu_S=\frac{\sum_{c\in S}w_cx_c}{\sum_{c\in S}w_c} $$再从该节点内部的质量加权协方差中求第一主轴 (a_S),并把每个 context 投影到这条轴上:
$$ q_c=(x_c-\mu_S)^\top a_S $$所有 context 按 (q_c) 排序,前一半进入左 child,后一半进入右 child。这个动作递归四层:
$$ c\longrightarrow(r_1,r_2,r_3,r_4), \qquad r_d\in\{L,R\} $$例如 (L,R,L,R) 就是一个 context 的叶地址。每一层都在当前局部节点重新计算主轴,所以后续
分裂不是重复 root 的同一条判别线。
还有一个容易混淆的细节:主轴方向受语料质量 (w_c) 加权,但左右拆分按 context 数量各取 一半。 因此每个叶节点恰好容纳 256 个 context,却不保证每个叶节点承载相同的语料概率 质量。前者控制结构容量,后者仍由真实共现统计决定。
叶节点的概率质量从哪里来
树建好后,对目标 token (t) 和叶节点 (L_i),将该叶包含的 context 共现计数相加:
$$ m_t(i)=\sum_{c:\,r(c)=i}N_{t,c} $$再加平滑并归一化:
$$ p_t^{(16)}(i)= \frac{m_t(i)+\alpha} {\sum_j m_t(j)+16\alpha} $$因此,某个叶节点对 banana 的概率质量较大,不是因为这个叶“更大”,而是因为 banana 在
语料中更多地与落到该叶的 context 共现。所有目标 token 共用同一棵 context 树,但各自拥有
不同的质量分布:
这就是 T0 的 embedding。它不是 token ID 的随机查找表:每一维都表示“目标 token 在某片 条件上下文区域中占有多少概率质量”。
树决定坐标轴的含义,语料计数决定 token 在各坐标上的值。若树分得没有结构,不同关系会被 混入同一坐标;若树的递归分解有效,相近的 context 会被聚合,有限维表示就能保留更多可检索 信息。这正是学习分区需要和同容量随机分区比较的原因。
为什么它天然是多尺度的
较粗尺度不重新训练,也不创建另一套 embedding,而是把相邻子树的概率质量相加:
$$ p_t^{(K)}(j) =\sum_{i\in\operatorname{desc}(j)}p_t^{(16)}(i), \qquad K\in\{1,2,4,8,16\} $$因此同一个 token 可以在多个尺度被读取:
- (K=1):只知道总概率为 1,所有 token 完全相同;
- (K=2):只观察最粗的左右差异;
- (K=4,8):逐步暴露中尺度条件结构;
- (K=16):读取当前实验允许的最细概率场。
一个四叶 toy 可以直观看到这个过程。假设四个叶区域分别聚合了不同的 context 群,而
banana 与这些区域的共现质量为 55/25/12/8。归一化后的细尺度状态为:
合并相邻叶后:
$$ p_{banana}^{(2)}=(0.80,0.20) $$再合并到 root:
$$ p_{banana}^{(1)}=(1.0) $$粗尺度保留“主要落在左半空间”这一事实,却丢掉左半内部的 0.55/0.25 区别。分辨率提升时,
被隐藏的区别重新变得可见;这正是本实验测量的压缩失真来源。
如何把概率场用于检索
对留出数据中的某个查询 token (q),先得到它在 (K) 个概率区域中的新计数 (n_q(j))。然后对 词表中的每个候选 token (t) 计算后验打分:
$$ z_t^{(K)}(q)=\log\pi_t+ \sum_{j=1}^{K}n_q(j)\log p_t^{(K)}(j) $$其中 (pi_t) 是目标 token 的先验。若压缩后的概率场保留了身份相关的条件结构,正确 token 就应当在候选列表中获得更高排名。
NLL 测量正确答案获得的概率代价,越低越好;MRR 测量正确答案排名倒数的平均值,越高越好。 它们比只在训练计数上寻找近邻更严格,因为查询计数来自未参与建树的 20,000 行文本。
第一条工程率失真曲线
这里的“率失真”是工程近似,而不是已经完成比特量化的 Shannon rate-distortion 定理。
- 率的代理量是每个 token 可见的概率区域数 (K),其单纯形自由度为 (K-1);
- 失真由留出检索 NLL 表示;
- 4,096 维完整 context 场被聚合成 16 维时,若忽略所有 token 共享的树结构和浮点量化细节,
每 token 概率数组缩小约
256:1。
TreeHeap 的逐级 NLL 收益为:
$$ \Delta D_{1\to2}=1.054810, \quad \Delta D_{2\to4}=1.071249, $$$$ \Delta D_{4\to8}=0.917611, \quad \Delta D_{8\to16}=0.634925 $$所有增量都为正,且后两级出现边际收益下降。这说明当前 16 叶概率场没有饱和到“增加尺度也没有 信息”,但也不能据此外推 32、64 或完整 4,096 维仍会按同样速度改善。
随机分区也会随 (K) 增加而改善,因为更多可见区域本身就增加容量。真正重要的控制是:在相同 容量下,语料条件分区始终比随机分区更低的 NLL。16 叶尺度的差值为:
$$ 7.241480-6.274350=0.967130 $$因此,收益不能只归因于“多放了几个 float”;分区结构本身参与了信息保留。
词频基线为什么不能当作无损上界
SimLex 外部测量得到:
| 表示 | Spearman rho |
|---|---|
| TreeHeap 16 叶概率场 | 0.120264 |
| 随机 16 叶概率场 | 0.051110 |
| 词频接近度 | 0.123533 |
看到 0.120264 < 0.123533,最容易产生的误读是:“TreeHeap 压缩后不如词频,所以信息丢失
过多。”这个推论不成立。
本实验的词频分数只是:
$$ s_{freq}(i,j)=-|\log f_i-\log f_j| $$它询问两个词是否具有相近的出现频率。它没有编码 4,096 维条件概率场,也没有承担从粗到细 重构或检索的任务。因此它既不是未压缩表示,也不是零失真上界。
词频与人工相似度可能通过常用程度、词性、分词形态和 SimLex 样本构成发生相关。TreeHeap 在 强压缩下获得接近词频的外部相关性是值得记录的,但不能被写成“语义已经形成”;反过来,也 不能因为略低于词频就否定压缩保真度。
正确的结论应拆成两条:
- 压缩保真度得到初步支持:多尺度 NLL 连续改善,并稳定优于同容量随机分区;
- 独立语义结构仍然开放:尚未证明 SimLex 信号在控制词频、词性和形态后仍然存在。
为什么老师盲评不能进入结论
本次还让本地 Qwen3-8B 对 120 个双顺序问题进行盲评。所有输出都能解析为 JSON,但老师只得到:
- SimLex 校准准确率:
0.725,低于预注册门0.75; - A/B 交换后的顺序一致率:
0.325,远低于门0.90。
老师明显受选项顺序影响,所以全部偏好统计被作废。这里失败的是评审协议,不是 TreeHeap embedding;同样,它也不能被解释为支持 embedding。保留这个失败结果,是为了防止主观样例在 缺乏稳定评审器时替代可复现测量。
当前能公布什么
可以公布:
- TreeHeap 得到了一个合法、守恒、非随机的多尺度词级概率表示;
- 在
1/2/4/8/16尺度上观察到连续的留出率失真曲线; - 学习分区在相同容量下优于随机分区;
- 16 叶概率状态已经支持明显高于先验的词身份检索。
不能公布为既成事实的内容包括:
- TreeHeap 已经解决通用 embedding;
- 这些节点天然等于人类语义类别;
- 当前表示已经处理一词多义或句中 occurrence;
- 它已经能够驱动句子 FOLD、READ、翻译或生成;
- 当前曲线已经证明移动设备上的功耗或内存优势。
下一步不是盲目扩大语料
下一轮应优先提高结论的可识别性,而不是只增加样本量:
- 用至少三个固定 seed 复现树分裂和完整曲线;
- 加入完整 4,096 维场、PCA、聚类和匹配容量投影,形成真正的压缩参照系;
- 计算控制 log-frequency 后的 SimLex 偏相关;
- 分别报告词性、词形和子词边界分组,判断当前树首先学到了什么;
- 只有词级概率场稳定后,再将同一多尺度坐标接入句中 occurrence 和后续 FOLD/READ。
复现入口
代码、预注册与证据位于:
ara/s1-echo/src/s1_multiscale_probability_embedding_t0.py
ara/s1-echo/src/s1_embedding_teacher_blind_eval_t0.py
ara/s1-echo/logic/multiscale_probability_embedding_t0.md
ara/s1-echo/evidence/s1_multiscale_probability_embedding_t0/
正式任务为 io task 649,提交归档为 SameTime commit 4fe229a。输入语料、SentencePiece、
SimLex 和正式 summary 的 SHA-256 均保存在 evidence 中。
T0 还没有给出完整语义空间,但它完成了一件更基础的事:让 TreeHeap 的“分辨率”第一次不再 只是结构隐喻,而成为可以沿尺度读取、可以测量信息损失、也可以被随机对照否证的概率表示。
License: GPLv3