这篇接在 094 后面
SPR-094 证明了一件很窄、但很关键的事:
真实语料的 4,096 维上下文条件场,可以被压缩成 1/2/4/8/16 个概率区域;分辨率越高,
留出检索 NLL 越低,而且同容量下优于随机分区。
但 094 只证明了“这个坐标能保存信息”。它没有回答:
当一句话中的上下文一个接一个出现时,这些概率坐标能不能真正参与条件推断?
T1 就是为这个问题设计的。它不训练 Decoder,不生成句子,也不把 TreeHeap 写成已经完成的语言 模型。它只把一个词遮住,然后观察周围词逐个进入时,候选词的后验概率怎样变化。
先用一个 toy 看懂它
假设遮住了下面句子中的一个词:
Sisyphus ____ the stone uphill every day.
目标词可能是 pushes,也可能是 sees、finds、drops。在没有上下文时,系统只能使用词频
先验。随后按固定顺序暴露邻近词:
stone -> Sisyphus -> uphill -> every
SPR-094 已经把每个 context token 放进一棵 16 叶树。T1 不直接拿 context ID 做查表,而是先问: 这个 context 落在哪个多尺度概率区域?
在尺度 K 下,目标词 t 与概率区域 b 的条件关系为:
观察到 m 个上下文区域后,候选词的打分为:
这里:
pi(t)是词频先验;p_K(b_r|t)表示候选词与当前上下文区域的训练共现关系;Z把全部候选词重新归一化,使概率和为 1;q_K是看到当前上下文后,对被遮住词的完整后验分布。
如果 stone 所在区域经常与 pushes 共现,pushes 的概率就会上升;如果再看到 uphill,而
它提供了新的区分信息,候选范围应进一步收窄。这就是本文所说的“后验退火”:不是温度数字
机械下降,而是观测增加后,概率质量从大量候选逐步集中到较小集合。
“更确定”和“更正确”不是一回事
后验熵定义为:
$$ H_K(T\mid b_{1:m}) =-\sum_t q_K(t\mid b_{1:m})\log q_K(t\mid b_{1:m}). $$熵降低,只说明分布更集中。它没有保证正确答案的概率一定更高。
正确答案的负对数似然为:
$$ \operatorname{NLL}=-\log q_K(t_{gold}\mid b_{1:m}). $$因此必须同时观察:
- 熵是否下降,即系统是否变得更确定;
- gold NLL 是否下降,即这种确定是否朝正确答案移动。
如果熵下降而 NLL 上升,系统不是“没有学到信息”,而是过度相信了重复或相关的证据。 这个区别后来成为 T1 最重要的新发现。
Parent 没有 token,loss 从哪里来
这里很容易产生一个关键疑问:leaf 上可以观察到 token 的概率质量,但 parent 本身没有 token, 它的目标和 loss 应该怎样计算?
答案是:parent 不需要拥有一个 token。它表示一组后代 leaf 的概率区域,目标质量由这些 leaf 相加得到。
考虑一棵只有四个 leaf 的树:
                 root
               /      \
          parent A   parent B
           /    \      /    \
         L1     L2   L3     L4
假设某个目标的经验 leaf 概率场是:
$$ r=(0.50,\ 0.30,\ 0.15,\ 0.05). $$那么两个 parent 的目标质量不是额外标注出来的,而是后代质量之和:
$$ r(A)=r(L_1)+r(L_2)=0.80, $$$$ r(B)=r(L_3)+r(L_4)=0.20. $$所以 root 的粗尺度目标场为:
$$ r_{root}=(0.80,\ 0.20). $$进入 parent A 后,只在它自己的两个 child 中重新条件归一化:
$$ r(L_1\mid A)=\frac{0.50}{0.80}=0.625, \qquad r(L_2\mid A)=\frac{0.30}{0.80}=0.375. $$parent B 同理:
$$ r(L_3\mid B)=0.75, \qquad r(L_4\mid B)=0.25. $$这样,树学习的并不是“每个 parent 对应哪个 token”,而是一组局部条件选择:
root: A=0.80, B=0.20
A:    L1=0.625, L2=0.375
B:    L3=0.750, L4=0.250
沿路径重新相乘即可恢复 leaf 概率。例如:
$$ P(L_1)=P(A)P(L_1\mid A)=0.80\times0.625=0.50. $$单个正确 leaf 的路径 loss
如果一次观测的正确位置是 L2,那么监督信号可以分成两次局部选择:
root:选择 A
A:选择 L2
对应 NLL 为:
$$ L_{root}=-\log q(A), $$$$ L_A=-\log q(L_2\mid A). $$路径总损失是:
$$ L_{path} =-\log q(A)-\log q(L_2\mid A) =-\log\left[q(A)q(L_2\mid A)\right] =-\log q(L_2). $$因此,只要条件概率严格一致,逐层路径 NLL 与直接计算正确 leaf 的 NLL 相同。区别在于,路径 形式明确告诉每一层:本层只负责当前分叉新增的区分信息。
一般化到深度 D:
这也说明为什么不能把每个尺度的完整预测 NLL 再全部相加。粗尺度已经计算过的质量如果在细尺度 被完整重复计算,就会让同一事实多次进入 loss。路径条件分解只让每个节点支付一次局部分叉代价。
Parent 当前有什么含义
在 T1 中,树的 leaf 和 parent 划分的是 context token 的条件区域。对于候选目标 token t,
某个 parent 的概率质量为:
当句子中观察到一个 context token c 时,它在每个尺度上都有唯一的祖先区域。T1 读取的是
候选词与该区域的条件关系,而不是要求 parent 自己变成一个可输出 token。
因此,当前 parent 最严格的定义是:
后代 leaf 概率质量的粗分辨率区域,以及通向下一层 child 的条件路由状态。
我们不能仅凭求和就把某个 parent 命名为“水果”“动作”或“主体”。如果未来发现香蕉、梨、苹果 稳定聚集在同一 parent,并且这个 parent 在未见数据中仍提供可复现的预测收益,才有证据说它 形成了某种粗粒度概念。
这个区分也把两个问题分开了:
- 计算问题:parent 的质量和路径 loss 可以由 leaf 严格推出;
- 语义问题:parent 是否形成可命名、可迁移的概念,仍需独立实验。
正式实验怎样避免偷看答案
正式任务在 io 的 RTX 3090 上执行,任务号为 650/651。合同如下:
| 项目 | 设置 |
|---|---|
| WMT 英文侧扫描 | 200,000 行 |
| 目标词表 | 8,192 token |
| context 词表 | 4,096 token |
| 留出事件 | 50,000 个 masked-token 事件 |
| 每个事件可见上下文 | 1、2、4 个 |
| 读取尺度 | 1、2、4、8、16 bins |
| 随机控制 | 3 棵匹配容量的平衡随机树 |
| 区间估计 | 1,000 次配对 bootstrap |
源语料行号 mod 10 == 0 的文本只用于留出测试,不参与建树和条件计数。每个事件必须具有四个
词表内邻近上下文,因此 m=1/2/4 比较使用完全相同的 masked-token 样本。
除了学习树,实验还有三个控制:
K=1的词频先验;- 三棵相同叶容量、相同平滑、相同事件顺序的随机树;
- 直接使用全部 4,096 个 context ID 的未压缩 Naive Bayes 参考。
最后一项容量大得多,所以只能回答“压缩损失还有多大”,不能作为匹配成本的竞争者。
正式结果
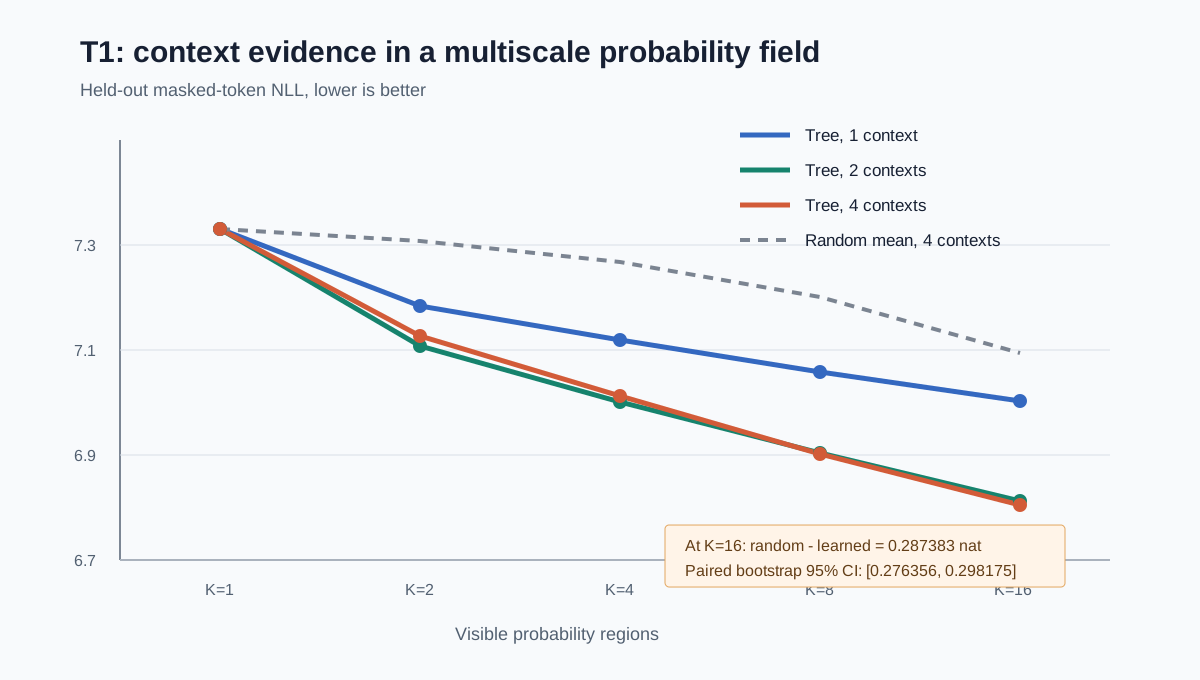
TreeHeap 的留出 NLL 如下,越低越好:
| 可见区域数 K | 1 个上下文 | 2 个上下文 | 4 个上下文 | 随机树 4 上下文均值 |
|---|---|---|---|---|
| 1 | 7.268692 | 7.268692 | 7.268692 | 7.268692 |
| 2 | 7.121257 | 7.046452 | 7.065414 | 7.246786 |
| 4 | 7.055921 | 6.940678 | 6.951110 | 7.206609 |
| 8 | 6.993862 | 6.843883 | 6.842157 | 7.140439 |
| 16 | 6.938479 | 6.753027 | 6.745880 | 7.033263 |
在 16 个概率区域、4 个上下文处:
$$ \operatorname{NLL}_{random}-\operatorname{NLL}_{tree} =0.287383. $$配对 bootstrap 的 95% 区间为:
$$ [0.276356,\ 0.298175]. $$区间整体大于 0,说明这里看到的优势并非只来自一次样本均值波动。它仍然是单语料、单 learned tree 的点估计,不能自动升级成跨语料架构定律。
从一个上下文增加到四个上下文时,16-bin TreeHeap 的后验熵下降:
$$ 7.025415-6.470929=0.554486\ \text{nat}, $$gold NLL 同时下降:
$$ 6.938479-6.745880=0.192599\ \text{nat}. $$这说明上下文不只让分布变尖,也让正确词平均获得更高概率。
粗分辨率已经能读到信息
如果所有有效关系只存在于最细的 16 个叶节点,那么 4-bin TreeHeap 不应稳定优于 4-bin 随机树。 实际结果是:
$$ 7.206609-6.951110=0.255499. $$也就是说,把 16 个叶节点合并成四个较粗区域以后,学习树仍然保存了可用条件结构。这是对 “多分辨率表示”的直接支持:粗尺度不是空壳,也不只是细尺度数组换一个名字。
但这项结果只说明词汇条件关系能够跨尺度读取。它没有证明 parent 已经是句义,也没有证明 root 可以恢复完整句子。
反例:第四个证据可能让系统更自信,却更错
未压缩 4,096-context 参考的 NLL 是:
| 可见上下文数 | NLL |
|---|---|
| 1 | 6.250681 |
| 2 | 5.714359 |
| 4 | 6.044044 |
从两个上下文增加到四个上下文后,后验熵继续下降,但 gold NLL 反而上升。这不是数据表写反了。
原因在于当前 reader 使用了条件独立假设:
$$ p(b_1,b_2,b_3,b_4\mid t) \approx \prod_{r=1}^{4}p(b_r\mid t). $$真实语言中的邻近词显然相关。例如 pushes、stone 和 uphill 不是三次互不相关的观测;它们
可能共同来自同一个短语或事件结构。直接相乘会把同一来源的信息重复计票,使后验过早变尖。
T1 的 16-bin 压缩树在正式数据中从 m=2 到 m=4 仍有轻微改善,但 smoke 曾出现小幅反弹。
因此,我们不能写成“TreeHeap 已经解决相关证据问题”。更准确的说法是:
压缩概率区域在这次正式实验中起到了部分正则化作用,但相关证据怎样累计,仍是 READ 必须 显式解决的算法问题。
为什么 Top-1 没有一起改善
16-bin TreeHeap 的 Top-1 从一个上下文的 0.05458 变为四个上下文的 0.05010,没有随着
NLL 单调上升。
这并不否定 NLL 的改善。NLL 测量整个概率分布是否给正确答案更多质量;Top-1 只看最大值对应 的一个 token。系统可能把正确答案从极低概率提升到第二、第三或第十名,从而改善 NLL,却仍未 越过排名第一的高频竞争者。
所以 T1 支持的是“后验信息与校准改善”,不是“argmax 解码已经更好”。在进入生成前,排名、 词序和序列决策仍需新的实验合同。
T1 改变了哪一段架构认识
094 之后,我们已经有三层可以区分的对象:
- 背景场:训练语料产生的 token-context 条件统计;
- 多尺度 Embedding:context 树与目标 token 的跨区域概率质量;
- 事件后验:当前句子暴露 context 后,对 masked occurrence 重新计算的候选分布。
第三层不是静态 token type 的另一张表,而是同一个 token 在当前句子中的 occurrence state。它 开始回答过去反复出现的问题:静态 Embedding 怎样进入一次真实语言事件?
当前链路可以写成:
$$ \text{corpus} \longrightarrow \text{background field} \longrightarrow \text{multiscale type embedding} \longrightarrow \text{context posterior occurrence}. $$但链路还没有接到可训练的句子 FOLD、分辨率感知 READ 与 autoregressive Decoder。因此它是接口 前的可行性证据,不是端到端模型的完成声明。
后续更新:概率场里真的有金字塔吗
在完成 T1 后,我们增加了 M1“多尺度概率场显微镜”。它专门回答一个比 NLL 更结构化的问题:
各尺度之间是否存在类似 Fourier 级数或图像金字塔的递归规律?
这里必须先区分两种金字塔。
T0:质量金字塔
对任意 parent,左右 child 质量满足:
$$ m_n=m_L+m_R. $$再定义局部分叉概率:
$$ a_n=\frac{m_L}{m_L+m_R}. $$则:
$$ m_L=m_na_n, \qquad m_R=m_n(1-a_n). $$因此 16-leaf 概率场可以精确改写成 15 个内部节点分叉概率。parent 保存粗质量,局部分叉参数 保存合并时丢失的细节。这类似树上的 Haar 小波,但它首先是一个数学恒等式,不能单独算作发现 了语言规律。
T1:后验修正金字塔
T1 的各尺度后验都定义在相同的 token 候选集合上,所以它们不是简单的 parent 求和。尺度从
K 变为 2K 时,细后验等于粗后验加入局部分叉证据后重新归一化:
在 200K 语料、50,000 个正式 masked-token 事件上,这个递推式的最大绝对数值闭合误差为:
$$ 1.144409\times10^{-5}. $$所以 T1 确实具有一种“粗后验 + 局部细节”的精确递归表示。
真正观察到的结构:有效信息前置
四上下文时,从 K=1 到 K=16,learned topology 对正确词产生的平均总对数概率增益为:
其中到 K=4 已经获得的比例为:
| topology | 到 K=4 已获得的总增益比例 |
|---|---|
| learned tree | 0.607451 |
| random tree mean | 0.263590 |
| learned-leaf permutation mean | 0.378829 |
也就是说,learned tree 不只是最终 16-leaf 概率场有效;它把较多有助于正确词判断的信息安排在了
较粗的前两次分裂中。打乱同一组 leaf 的排列以后,最终 K=16 表示没有丢失,但这种粗尺度
前置显著减弱。这才是当前可以支持的“内部金字塔”证据。
没有观察到简单的级数衰减
learned tree 四个深度的 Haar 式细节能量为:
0.321586 / 0.158577 / 0.312618 / 0.299835
held-out cross-entropy 的逐层贡献为:
0.518268 / 0.608847 / 0.522474 / 0.531875
它们都没有随深度单调下降。因此不能把当前概率场描述成“低阶项最大,越高阶越小”的简单 Fourier 式级数。更准确的说法是:粗层优先组织了一部分有判别力的信息,但细层仍保存大量 不可忽略的修正。
另外两个探索门失败了:
- 保留四个最大细节参数时,learned JS 重建误差为
0.028009,随机树反而只有0.008186。 随机混合会产生更平滑、更容易近似的场,因此“容易压缩”不能单独代表结构更好; - 二次 parent-to-child 回归的 held-out R-squared 为
0.124078,高于随机树的0.038021, 但低于 leaf permutation 的0.216238。所以当前没有证据宣布一个统一低阶多项式就是 F。
M1 最终留下的结构认识是:
T0: parent mass + local split detail -> exact leaf field
T1: coarse posterior + local log-evidence residual -> exact fine posterior
learned topology: useful evidence is statistically front-loaded toward coarse scales
它比“所有系数逐层缩小”弱,但比“只有 16 个无关 float”强。
后续还要解决什么
T1 暴露的下一问不是“再增加几个上下文”,而是:
两条相似证据应该完整累加,还是只有它们带来的新区分信息才应该累加?
T2 有四个候选机制:
| 机制 | 核心动作 | 优点 | 风险 |
|---|---|---|---|
| 证据温度 | 将总 evidence 乘以可学习或校准的 lambda |
简单、可作为基线 | 只缩放总量,不识别重复来源 |
| 重复区域去重 | 同一概率区域重复出现时降低后续权重 | 直接针对重复 bin | 不同 token 落在同一区域也可能提供新信息 |
| 新信息加权 | 只按新增 KL、熵降或区分度累计证据 | 接近真正问题 | 需要定义稳定、可微的增量信息 |
| 粗细分层累计 | 粗层决定类别,细层只补充类别内部身份 | 与 TreeHeap 多尺度结构一致 | 必须防止粗层错误锁死细层 |
当前建议是:先用证据温度建立一个不会偷看 test 的校准基线,再测试“新信息加权 + 粗细分层” 是否能在相同事件上同时改善 NLL、Top-1 和校准,而不是只让熵继续下降。
dev/test 必须重新隔离。参数只能在 dev 上选择,sealed test 只打开一次;否则 T2 会把后验校准 变成对 T1 测试集的人工拟合。
当前结论边界
T1 现在可以支持:
- 学习树的概率区域可以参与留出 masked-token 条件推断;
- 更多上下文在正式预算上降低了 TreeHeap 后验熵与 gold NLL;
- 有效结构存在于 4-bin 粗尺度,不只存在于 16-bin 叶层;
- 相关上下文会让独立似然乘法过度计票,下一步需要显式校准。
T1 现在不能支持:
- TreeHeap 已经学会句义压缩;
- parent 或 root 已经形成自然语言概念;
- FOLD/READ 私有协议已经闭合;
- Top-1、BLEU 或自由生成已经改善;
- 多尺度概率树已经优于 Transformer;
- 上下文越多,结果必然单调变好。
截至 095,TreeHeap 的最新窄结论是:语料背景可以被压缩为可逐尺度读取的概率坐标;当前 句子的上下文也能在这个坐标中形成更集中的 token 后验。真正尚未解决的,是如何只累计新的 证据,而不把语言中的相关性重复计算。